Pare de olhar para as planilhas de marketing que celebram o aumento nos Teraflops. Esse é um indicador para turistas. No submundo da infraestrutura de ponta, onde a NVIDIA dita as regras com a arquitetura Blackwell, a métrica que realmente decide quem sobrevive ao treinamento de modelos de trilhões de parâmetros não é a velocidade do núcleo, mas a largura de banda da memória e a eficiência do barramento. Convenhamos: o silício isolado morreu. O que Jensen Huang está vendendo agora não são chips, mas uma infraestrutura de rack que se comporta como um único computador gigante. A complexidade técnica escalou de tal forma que o processador individual tornou-se apenas um componente periférico em um ecossistema de interconexão proprietária.
A grande mudança técnica reside na introdução da precisão FP4 (ponto flutuante de 4 bits). Para o leigo, parece apenas uma redução de precisão; para o engenheiro, é o único caminho para sustentar o throughput necessário para os LLMs de próxima geração. Ao reduzir a precisão de FP8 para FP4, a NVIDIA dobra a capacidade de computação sem dobrar o consumo de energia no núcleo. Mas há um custo invisível. Essa redução exige que o software de orquestração seja absurdamente mais sofisticado para evitar que a degradação do modelo torne a IA inútil. Estamos trocando a precisão matemática bruta por uma eficiência estatística orquestrada, e é aqui que o domínio da NVIDIA se consolida: eles controlam tanto o silício que executa quanto o software que compensa a perda de precisão.
E tem mais. O verdadeiro herói ou vilão, dependendo do seu nível de dependência do fornecedor é o NVLink de 5ª geração. Enquanto a indústria tenta desesperadamente padronizar o Ethernet para IA, a NVIDIA dobrou a aposta em um protocolo proprietário que oferece 1.8 TB/s de largura de banda bidirecional por GPU. Isso é decisivo. Em modelos onde os pesos são distribuídos por centenas de GPUs, o tempo gasto esperando os dados viajarem entre os chips é o maior ralo de dinheiro de um data center. A arquitetura Blackwell não resolve o problema do processamento; ela tenta mitigar o desastre da comunicação. Se o dado não chega ao núcleo a tempo, não importa se você tem 20 ou 200 petaflops de poder teórico; você tem apenas um aquecedor de sala muito caro.
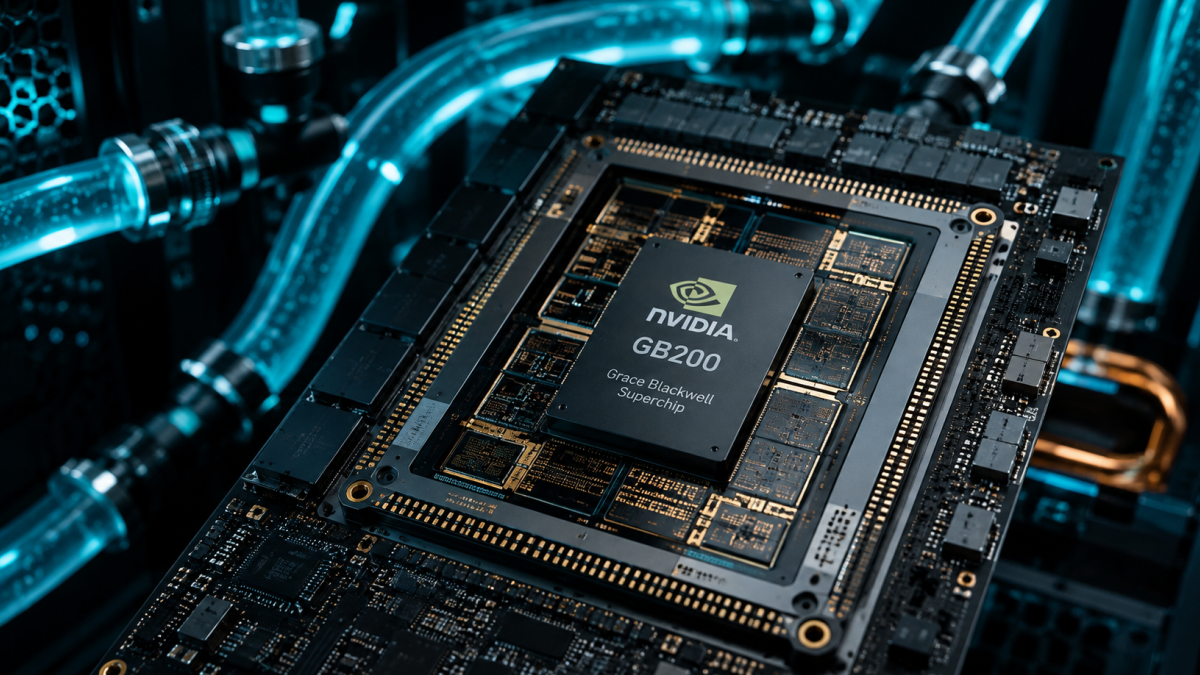
Falando em aquecimento, a exigência de resfriamento líquido no sistema GB200 NVL72 não é uma escolha estética, é um atestado de falência térmica do silício tradicional. Estamos empurrando os limites da física a um ponto onde o ar não consegue mais remover o calor gerado pela densidade de transistores. Imagine que você está tentando resfriar um motor de jato com um ventilador de teto; é impossível. A migração para o resfriamento líquido direto na placa (direct-to-chip) introduz uma camada de complexidade operacional que muitos data centers legados simplesmente não conseguem suportar. Isso cria uma divisão brutal no mercado: ou você constrói uma catedral de energia e refrigeração do zero para abrigar Blackwell, ou você se torna um cidadão de segunda classe na corrida pela IA.
Talvez eu esteja sendo pessimista com a soberania de quem tenta competir, mas o “Muro da Memória” (Memory Wall) continua sendo a fronteira final. Mesmo com o uso de HBM3e (High Bandwidth Memory), a capacidade da memória de vídeo não cresce no mesmo ritmo que a demanda dos modelos. A resposta da NVIDIA foi fundir o chip Grace (CPU) com o Blackwell (GPU) em um superchip único. Essa integração profunda permite que a GPU acesse a memória da CPU de forma muito mais fluida, mas sela definitivamente o destino do cliente: você não pode mais trocar apenas a GPU ou apenas o processador. O hardware tornou-se um bloco monolítico de decisão estratégica. Fora isso, a arquitetura Blackwell introduz o motor de descompressão dedicada, uma tentativa técnica de aliviar o gargalo de entrada e saída de dados (I/O) que assombra os clusters de treinamento.
O resumo é que o processador genérico acabou. Não existe mais espaço para o chip que “faz tudo um pouco”. Estamos entrando na era da especificação radical. A arquitetura da NVIDIA é desenhada para um fim específico: a multiplicação de matrizes em escala de data center. Tentar usar esse hardware para qualquer outra coisa é um desperdício de capital. Note que a eficiência aqui não é medida por tarefa, mas por dólar gasto por token gerado. Cada transistor no Blackwell foi colocado ali para servir à lógica dos transformadores. Se a arquitetura dos modelos de IA mudar drasticamente para algo que não dependa de tensores massivos, bilhões de dólares em silício especializado se tornarão obsoletos da noite para o dia. É uma aposta de risco altíssimo, disfarçada de progresso inevitável.
Sendo otimista por um momento, a capacidade de processamento de inferência do Blackwell é, tecnicamente, um salto de 30 vezes em relação ao H100. Isso reduz o custo marginal da inteligência artificial para o usuário final, mas aumenta o custo de entrada para qualquer novo competidor de hardware. Como você compete com uma empresa que não apenas projeta o chip, mas também o switch de rede, o protocolo de comunicação, o sistema de refrigeração e a stack de software que compensa a falta de precisão dos cálculos? A NVIDIA deixou de ser uma fabricante de componentes para se tornar a concessionária de energia da era da informação. O chip é apenas o cabo por onde a energia passa.
Pra fechar, a pergunta que os CTOs devem se fazer diante da nova geração da NVIDIA não é quantos GB200 eles podem comprar, mas se eles estão preparados para o aprisionamento técnico (vendor lock-in) mais profundo da história da computação. Ao adotar Blackwell, você não está comprando um processador; você está adotando um sistema operacional de data center proprietário que vive abaixo da camada do software. A vantagem técnica é inegável, o desempenho é estonteante, mas o custo da liberdade nunca foi tão alto no mundo do silício. Você está construindo sua infraestrutura sobre um motor de inovação ou sobre uma gaiola dourada que você nunca poderá abrir?